
AI 인프라 소프트웨어 기업 래블업이 자체 개발한 오픈소스 AI 추론 엔진 'MLxcel'의 지원 범위를 AMD 플랫폼으로 확대했다. 애플 실리콘과 엔비디아 CUDA에 이어 AMD ROCm까지 공식 지원한다. AMD 환경에서 자체 최적화한 일부 모델의 입력 처리 속도는 약 70배 높아졌다.
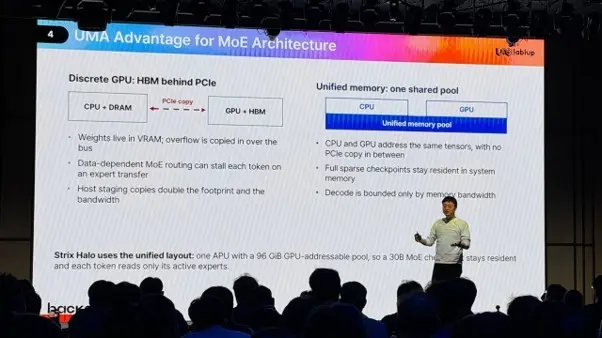
신정규 래블업 대표는 최근 서울 강남구에서 열린 'AMD Advancing AI World Tour Seoul 2026'에서 AMD 프로세서 'Strix Halo' 기반 대규모언어모델(LLM)·비전언어모델(VLM) 추론 최적화 기술을 소개했다.
MLxcel은 LLM과 이미지·텍스트를 함께 처리하는 멀티모달 AI 모델을 실행하는 오픈소스 추론 엔진이다. CPU와 GPU가 메모리를 공유하는 통합 메모리 아키텍처(UMA)에 맞춰 메모리 활용과 추론 속도를 최적화하도록 설계됐으며, 여러 사용자의 요청을 처리하는 추론 서빙 기능도 제공한다.
래블업의 자체 측정 결과 'gpt-oss-20b(MXFP4)' 모델의 입력 처리(prefill) 속도는 최적화 전 초당 7.5토큰에서 526토큰으로 약 70배, 토큰 생성(decode) 속도는 8.3토큰에서 63.6토큰으로 약 7.7배 높아졌다. 'Llama 3.1 8B' 4비트 모델의 최대 메모리 사용량은 20.6GB에서 6.1GB로 약 70% 줄었고 생성 속도는 유지됐다. 해당 메모리 측정 결과는 지난 9월 기록에 근거한다.
래블업은 지난 3일 AMD 라이젠 AI 맥스+ 395·라데온 8060S, 메모리 96GiB 환경에서 MLxcel 0.8.1의 성능도 측정했다. 'Gemma 4 31B' 4비트 모델의 입력 처리 속도는 초당 315토큰으로 외부에 공개된 llama.cpp(Vulkan)의 260토큰보다 약 21% 높았다. 반면 생성 속도는 MLxcel이 10.2토큰, llama.cpp가 10.5~10.9토큰으로 비슷하거나 소폭 낮았다. 다만 서로 다른 장비에서 측정된 수치여서 직접적인 성능 우위로 해석할 수 없다. MLxcel 측정 조건은 입력 512토큰, 출력 128토큰, 배치 1, 단일 스트림이다.
신 대표는 AI 모델의 규모가 커질수록 연산 성능뿐 아니라 메모리 활용 효율이 중요해진다고 강조했다. UMA 환경에서는 하드웨어 특성에 맞춘 실행 방식과 메모리 관리 기술이 추론 성능에 영향을 미친다는 설명이다.
MLxcel에는 여러 사용자의 추론 요청을 효율적으로 처리하는 '연속 배칭(Continuous Batching)'과 토큰 생성 속도를 높이기 위한 '투기적 디코딩(Speculative Decoding)' 등의 기술이 적용됐다. 신 대표는 "MLxcel은 통합 메모리 환경에서 최고 수준의 추론 성능을 목표로 개발됐다"고 말했다.
AMD 지원을 위한 안정화 작업도 진행됐다. Strix Halo 환경에서 AI 모델 44개의 실행을 확인했으며 ROCm 관련 코드 결함 70건을 수정하고 회귀 테스트를 추가했다. 96GiB 메모리 용량에 맞춘 예산 관리와 여러 작업이 동시에 실행될 때 발생할 수 있는 스레드 안전성, 캐시 일관성 문제도 개선했다.
래블업은 지난 5월 MLxcel을 오픈소스로 공개한 뒤 애플 실리콘과 엔비디아 CUDA를 지원해 왔다. 0.8 버전에서 AMD ROCm을 추가하며 멀티벤더 전략을 추론 엔진으로 확장했다. AI 인프라 관리 플랫폼 'Backend.AI'에서도 엔비디아·AMD·인텔 GPU와 리벨리온·퓨리오사AI 등 국내외 AI 가속기를 지원하고 있다.
AMD 지원은 현재 소스코드를 직접 빌드하는 방식이다. 깃허브 README에는 공식 지원으로 명시됐지만 일부 0.8.0 릴리스 문서에는 '실험적(Experimental)'으로 표기돼 있다. 래블업은 문서 갱신이 늦어진 것으로 정식 지원 기능이라고 설명했다.
래블업은 지난 3일 코스닥 시장에 상장했으며 국내외 120여 고객 사이트에 Backend.AI 플랫폼을 공급하고 있다.
신정규 대표는 "AI 추론 환경이 데이터센터, 에지, AI PC로 빠르게 확산되는 가운데 하드웨어에 독립적인 오픈소스 추론 플랫폼의 가치는 더 커질 것"이라며 "오픈소스 커뮤니티와의 협력을 통해 AI 인프라의 이식성과 선택권, 속도를 계속 확대해 나가겠다"고 말했다.

댓글 (0)
댓글을 작성하려면 로그인이 필요합니다.
로그인하기