
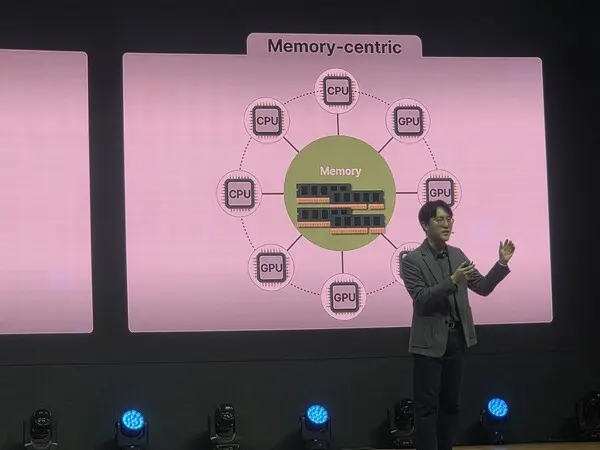
SK하이닉스가 인공지능(AI) 에이전트 확산으로 인한 병목 문제를 해결하기 위해, 개별 그래픽처리장치(GPU)·중앙처리장치(CPU)가 공유할 수 있는 메모리 풀을 구축하는 방안을 제시했다.
12일 주영표 SK하이닉스 부사장은 서울 코엑스에서 열린 '인텔 AI 서밋 서울 2026' 기조강연에서 이 같은 메모리 중심 시스템 아키텍처 전략을 소개했다.
현재는 각 GPU 주변에 여러 개의 고대역폭메모리(HBM)를 붙인다. 엔비디아의 차세대 아키텍처 기반 GPU 주변에는 여러 개의 고대역폭메모리(HBM4)가 물리적으로 둘러싸는 형태로 배치된다. 이 같은 구조는 연산 성능 대비 HBM의 물리적 탑재 공간과 용량이 한정되어 있어, 대규모 AI 연산 시 고질적인 병목 현상을 유발한다.
특히 AI 활용이 추론 중심, 대화를 주고받는 멀티턴 형태로 확산할 수록, 더 많은 메모리(HBM) 용량이 필요하다. 이전 대화 맥락을 기억해 답변을 이어가게 만드는 핵심 데이터인 KV캐시(대화·연산 맥락 저장 공간)가 폭발적으로 늘어나기 때문이다.
현재는 메모리가 부족할 경우, 기존의 KV캐시를 삭제해야 한다. 이 경우 작업을 이어가면서 다시 계산해야 하는 상황이 종종 발생한다. KV캐시를 SSD 등 별도 저장장치로 보내는 방법도 있으나, 이 또한 다시 가져오는 속도가 느리다.
이에 SK하이닉스는 일종의 공유 메모리 풀을 구축하고, 각 GPU·CPU에서 메모리 용량 부족이 발생할 때, 풀에 있는 남는 메모리로 KV캐시를 이전해 보관하는 활용 방식을 제안했다. 비유하자면 지금은 개인 작업대만 쓰는 환경인데, 앞으로는 여럿이 함께 쓰는 공용 선반을 들여놓자는 것이다.
공유 메모리 풀에서 KV 캐시 등을 불러오는 시간이 발생하지만, 그래도 KV 캐시를 재연산하는 것보다는 효율적일 수 있다는 설명이다. 실제로 SK하이닉스는 파트너사와 함께 멀티턴 AI 에이전트 환경에서 해당 방식을 시험했다. 기존 방식에서 메모리 부족 시 발생하던 극단적인 지연(Worst-case latency) 현상을 대폭 완화하여, 멀티턴(다중 대화) 환경에서도 안정적인 응답 속도를 유지하는 결과를 확인했다.
주 부사장은 "기존 방식은 KV캐시가 계속 증가하며 메모리가 부족하면 삭제 후 재연산해 일부 요청에서 응답시간 크게 증가하는 등 비효율적인 부분이 많다"며 "공유 메모리풀은 공용 메모리에 KV캐시를 저장 후 재활용해 응답 지연의 최악 구간을 개선하고 불필요한 재연산이 감소해 안정적인 AI 서비스 품질 유지에 효과적"이라고 말했다.
SK하이닉스는 이런 공유 메모리 형태의 아키텍처를 구현하기 위해, 인텔을 비롯한 파트너사와 관련 생태계를 공동 개발한다는 구상이다. 공유 메모리를 관리하고 데이터를 배분하는 역할을 CPU가 하기 때문이다.
주 부사장은 "메모리 기업 단독으로는 데이터센터 시스템의 구조적 혁신을 구현하기 어렵다"며 "고객사와 파트너 기업, 학계가 함께 새로운 아키텍처를 설계해야 한다"고 강조했다.

댓글 (0)
댓글을 작성하려면 로그인이 필요합니다.
로그인하기